第三部分:理解核心概念
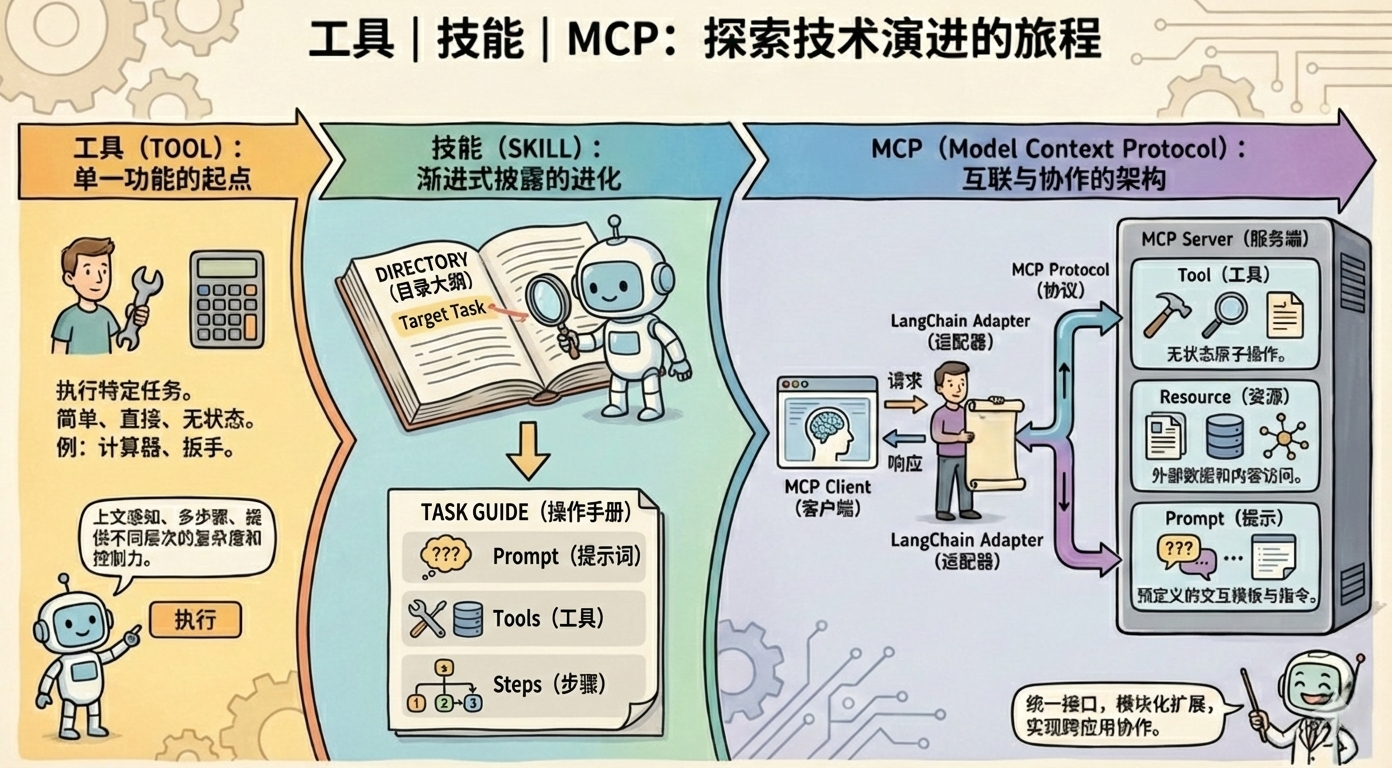
3.1 Tool、MCP、Skill —— 一句话理解
| 概念 | 一句话理解 | 类比 | 本质 |
|---|---|---|---|
| Tool | 执行具体操作 | "工具箱" | 原子函数 |
| MCP | 连接外部世界 | "感官" | 外部服务协议 |
| Skill | 知道怎么做 | "帮助手册" | 知识包 |
3.2 Skill 的设计原则
为什么需要 Skill?
在 FunctionCall 阶段,Agent 只能执行简单的工具调用。但复杂任务需要步骤化的指导:
用户: "帮我写一篇技术博客"

FunctionCall 阶段:
  Agent: "好的,我调用 write_file 工具"
  结果: 生成一篇空白的博客...

DeepAgent + Skill 阶段:
  Agent: "我有一个 industry-research-with-image 技能,让我读取它的指南"

  Skill 告诉 Agent:
 1. 先确定博客主题和目标读者
  2. 收集相关资料和数据
  3. 设计文章结构
  4. 撰写内容
  5. 添加配图
  6. 校对和修改

  结果: 一篇完整的技术博客
3.2.1 Skill 的渐进式披露设计
Skill 采用三层设计来管理上下文:
点击展开:渐进式披露三层架构图
┌─────────────────────────────────────────────────────┐
│  Layer 1: Metadata (元数据)                         │
│  - name: 技能名称                                    │
│  - description: 触发条件和用途                       │
│  始终加载 (~100 words)                              │
└─────────────────────────────────────────────────────┘
                         ↓
┌─────────────────────────────────────────────────────┐
│  Layer 2: SKILL.md Body (正文)                     │
│  - 核心工作流程                                     │
│  - 关键步骤说明                                     │
│  仅在技能触发时加载 (<5k words)                     │
└─────────────────────────────────────────────────────┘
                         ↓
┌─────────────────────────────────────────────────────┐
│  Layer 3: Bundled Resources (捆绑资源)              │
│  - scripts/: 可执行脚本                             │
│  - references/: 参考文档                            │
│  - assets/: 素材文件                                │
│  按需加载 (无限)                                    │
└─────────────────────────────────────────────────────┘
🤔 深度思考:如果我有 10,000 个 Skill 怎么办? 目前我们依靠 Agent 阅读存放有 skill 的目录来决定用哪个。但如果目录或知识文档成千上万,Agent 的"大脑容量"(Context Window)装不下怎么办?
- 现有方案:DeepAgent 目前依靠简单的文本匹配,也就是 Agent 根据文字进行主观判断。
- 未来方案:在**第六讲(RAG 检索增强生成)中,我们将学习"向量化(Embedding)"**技术。它能将文字转化为"数字坐标",让 Agent 像在图书馆查索引一样,瞬间在海量数据中通过"语义相似度"找到答案,而不需要通读全文。
3.2.3 如何配置Skill
将skill文件放置在项目根目录下的skills文件夹内即可
#skill文件示例结构如下
skill-name/
├── SKILL.md                 # 必需:元数据 + 操作指南
├── scripts/                 # 可选:可执行脚本
│   └── process.py
├── references/             # 可选:参考文档
│   └── guide.md
└── assets/                 # 可选:素材文件
    └── template.docx
3.3 什么是 MCP?
MCP(Model Context Protocol) 是连接外部服务的标准化协议,让 Agent 能够与外部信息进行交互。
类比:如果 Tool 是 Agent 的"手",MCP 就是 Agent 的"眼睛"——它让 Agent 能够"看见"和"接入"外部世界。
MCP 有 三大组件:
| 组件 | 作用 | 装饰器 |
|---|---|---|
| Tools | Agent 可以调用的操作 | @mcp.tool() |
| Resources | Agent 可以读取的数据 | @mcp.resource() |
| Prompts | Agent 可以使用的提示模板 | @mcp.prompt() |
MCP Server 和 MCP Client 的区别与联系
MCP 采用客户端-服务器架构,两个角色相互配合:
| 角色 | 说明 | 类比 |
|---|---|---|
| MCP Server | 提供具体服务的端,封装了外部能力 | 像"餐厅后厨",实际做菜 |
| MCP Client | 消费服务的端,连接并使用 Server | 像"顾客/服务员",点餐并接收菜品 |
本项目中的角色:
- DeepAgent 是 MCP Client:负责连接和管理多个 MCP Server
- fetch、worldbank 等是 MCP Server:提供网页抓取、经济数据等具体服务
关系特点:
- 一对多:一个 Client 可以同时连接多个 Server
- 标准化:通过统一协议通信,Server 可以被任何 Client 使用
- 解耦:Server 独立运行,Client 按需连接
Transport 传输方式:stdio 与其他方式
MCP 支持多种通信方式(transport):
| 方式 | 全称 | 适用场景 | 特点 |
|---|---|---|---|
| stdio | Standard Input/Output | 本地进程通信 | 简单、无需网络、本项目默认 |
| Streamable HTTP | Streamable HTTP | 远程服务 | 推荐使用,支持双向流式通信 |
| sse (弃用) | Server-Sent Events | 远程服务 | |
| websocket | WebSocket | 双向实时通信 | 低延迟,适合高频交互 |
为什么本项目使用 stdio?
- 简单易用:本地运行,无需配置网络端口
- 隔离性好:每个 MCP Server 是独立进程,崩溃不影响主程序
- 即开即用:通过
uvx/npx直接运行,零配置 - 教学友好:学生无需理解网络编程概念
stdio 方式的工作流程:
DeepAgent (Client)          MCP Server (如 worldbank)
        |                              |
        |--- 启动子进程 -------------->|
        |      (command: npx)          |
        |                              |
        |<-- 通过 stdin/stdout 通信 -->|
        |      (JSON-RPC 格式)         |
        |                              |
        |--- 发送工具调用请求 -------->|
        |<-- 返回执行结果 --------------|
3.3.1 何时使用 MCP,何时写 Python 代码?
这是一个常见的架构决策问题。核心矛盾是:标准化带来的通用性 vs 协议层带来的性能损耗。
一句话理解
| 方式 | 隐喻 | 特点 |
|---|---|---|
| Python Tool | 连通器 | 同进程,数据直接传递,零开销 |
| MCP | 传送带 | 跨进程,JSON 序列化传输,有延迟 |
决策对比表
| 场景 | 推荐方式 | 原因 |
|---|---|---|
| 异构语言(Python 调用 Go/Rust 工具) | MCP | 跨语言通信 |
| 需要复用(多个项目/用户共用) | MCP | 一次编写,到处运行 |
| 安全隔离(高危操作需要沙箱) | MCP | 独立进程,权限可控 |
| 高频计算(循环调用上千次) | Python Tool | MCP 序列化开销无法接受 |
| 复杂对象(DataFrame/大文件) | Python Tool | JSON 传输效率太低 |
| 快速原型(50 行代码验证) | Python Tool | MCP 配置太重 |
本项目实例
| 组件 | 类型 | 原因 |
|---|---|---|
| web_search | Python Tool | 简单函数,快速实现 |
| fetch MCP | MCP | 复用社区工具,标准化接口 |
| 股票行情 MCP | MCP | 外部 I/O,需要网络和隔离 |
决策流程
新功能 → 需要给其他项目用? → 是 → MCP
         ↓否
       复杂度高? → 是 → MCP
         ↓否
       高频/大数据? → 是 → Python Tool
         ↓否
       → Python Tool
3.3.2 如何配置 MCP 服务?
配置格式解析
MCP 服务器在 src/cufel_deepagent/mcp/mcp.py 中配置:
文件路径:src/cufel_deepagent/mcp/mcp.py
点击展开 fetch MCP 配置详解
# MCP_SERVERS_CONFIG 字典定义了所有可用的 MCP 服务器
# 框架启动时会自动连接这些服务器并获取其工具/资源/提示词
MCP_SERVERS_CONFIG = {
    "fetch": {
        # command: 运行 MCP 服务器的命令
        # "uvx" 是 Python 包运行器,类似 Node.js 的 npx
        # 作用:自动下载并运行 PyPI 包,无需预先 pip install
        "command": "uvx",

        # args: 传递给命令的参数列表
        # "mcp-server-fetch" 是 PyPI 上的包名
        # 这会运行:uvx mcp-server-fetch
        "args": ["mcp-server-fetch"],

        # transport: 通信协议
        # "stdio" 表示使用标准输入输出进行本地进程通信
        # 可选值:"stdio" | "sse" | "websocket"
        "transport": "stdio",
    }
}
其中的uvx、npx 是什么意思?
| 命令 | 来源 | 作用 | 使用场景 |
|---|---|---|---|
| uvx | Python (uv 工具) | 运行 PyPI 包而无需安装 | Python MCP 服务器 |
| npx | Node.js (npm) | 运行 npm 包而无需全局安装 | Node.js MCP 服务器 |
| python | Python 解释器 | 直接运行本地 Python 脚本 | 自定义 MCP 服务器 |
为什么要用 uvx/npx?
- 零安装体验:无需
pip install或npm install,自动下载运行 - 环境隔离:每个包独立运行,无版本冲突
- 教学友好:学生无需管理依赖,配置即可使用
添加新的 MCP 服务器步骤
以添加 fetch MCP 为例:
步骤 1:在 MCP_SERVERS_CONFIG 字典中添加新条目
MCP_SERVERS_CONFIG = {
    # ... 其他服务器
    "fetch": {
        "command": "uvx",              # 使用 Python 包运行器
        "args": ["mcp-server-fetch"],  # PyPI 包名
        "transport": "stdio",
    },
}
步骤 2:确保本地环境有对应运行器
- Python 包:
pip install uv或curl -LsSf https://astral.sh/uv/install.sh | sh - Node.js 包:
npm install -g npx(通常随 Node.js 安装)
步骤 3:重启 Agent,框架会自动连接新 MCP 服务器
MCP 信息自动注入系统提示词
cufel-deepagent 框架会自动将所有 MCP 服务器的信息注入到 Agent 的系统提示词中,包括:
| 信息类型 | 内容 |
|---|---|
| 服务器列表 | 已配置的 MCP 服务器名称和启动命令 |
| 可用工具 | 所有 MCP 工具及其描述 |
| 可用资源 | MCP Resource 的 URI 和描述 |
| 可用提示词 | MCP Prompt 的名称和内容 |
文件:src/cufel_deepagent/mcp/mcp_resources_prompts.py
# 系统启动时会自动调用这些函数,将 MCP 信息注入提示词
from cufel_deepagent.mcp import get_mcp_all_info_for_prompt

# 生成完整的 MCP 信息描述
mcp_info = get_mcp_all_info_for_prompt()
# 返回格式:
# ## MCP 服务器总览
# ### 已配置的服务器
# - fetch: `uvx mcp-server-fetch`
# - worldbank: `npx worldbank-mcp`
#
# ### 可用的 MCP 工具
# fetch:
#   - `fetch`: 获取网页内容
#   - `parse_pdf`: 解析 PDF 文档
# worldbank:
#   - `get-countries`: 获取国家列表
#   - `get-indicator`: 获取经济指标
#
# ### 可用的 MCP 资源 (Resources)
# - `resource://name`: 描述
#
# ### MCP 提示词 (Prompts)
# - `name`: 描述
#   内容预览...
这种设计让 Agent 能够:
- 知道有哪些 MCP 服务可用
- 了解每个工具的功能和用法
- 正确选择和使用 MCP 资源/提示词
- 无需阅读代码即可掌握 MCP 能力
3.4 三者如何协作?
用户请求:"分析中国和美国的经济对比"
         ↓
    Agent 理解意图(调用 Skill)
         ↓
    Skill 指导:"使用 worldbank MCP 获取 GDP 数据"
         ↓
    MCP 连接世界银行(获取数据)
         ↓
    Tool 执行具体操作(处理数据)
         ↓
    返回结果给用户
3.5 综合示例:撰写公司研究报告
为了更好地理解 Tool、MCP、Skill、SubAgent 如何协同工作,我们来看一个完整的示例:使用各种组件协同完成'带图公司研究报告'的撰写。
3.5.1 场景描述
我们刚刚搭建好了 DeepAgent,但它目前还只是一个"空壳"——什么也不会。
作为一名金融实习生,我需要经常撰写"公司研究报告"。具体来说,我希望 DeepAgent 能帮我:
-
【基础信息整理】 获取公司的基本面信息和财务数据
💡 注:目前使用的是框架内置的虚构示例数据(analyze-company),仅供格式参考,不是真实上市公司数据
-
【补充外部信息】 搜索真实的行业动态、市场趋势、相关政策
💡 虽然公司是虚构的,但所处行业是真实的,可以通过网络搜索获取真实行业背景
-
【增强可读性】 为报告配上简单的业务示意图或概念图,让报告看起来更专业
但问题是:DeepAgent 现在"手无寸铁",我们需要一步步教它:
- 使用 analyze-company skill 中配置的
get_company_info等工具获取公司内部数据(虚构示例数据) - 使用 web_search Tool 搜索真实的外部行业信息
- 使用 image-generator-agent SubAgent 生成配图
- 最后用 industry-research-with-image Skill 将整个流程编排起来
💡 Skill vs Tool 的关系:Skill 是"指导手册",告诉 Agent 应该按什么步骤执行任务;Tool 是"具体工具",实际执行数据获取等操作。例如 analyze-company skill 会指导 Agent 调用
get_company_info、get_financial_data等工具来获取数据。
这正是本示例要解决的问题:如何让 DeepAgent 从"零基础"成长为会写"带图公司研究报告"的小助手。
3.5.2 MCP:fetch MCP(网页内容获取)
功能:获取网页内容,读取互联网上的公开资料和行业信息
文件路径:src/cufel_deepagent/mcp/mcp.py
点击展开 fetch MCP 配置代码
MCP_SERVERS_CONFIG = {
    # 其他服务器配置...

    "fetch": {
        # 使用 uvx 运行 Python 包
        # 功能:将任意网页 URL 的内容转换为 Markdown 格式
        # 提供工具:获取网页正文、标题、链接等内容
        "command": "uvx",
        "args": ["mcp-server-fetch"],
        "transport": "stdio",
    },
}
关键说明:
fetchMCP 提供网页内容抓取能力- 可将任意网页 URL 转换为 Markdown 格式的文本
- 用于获取行业网站、新闻页面、公司官网等公开信息
- 注意❗️:部分网站包括反爬虫机制,此时fetch会失败
- 用法示例:Agent 会自动调用
fetch工具获取指定 URL 的内容
⚠️ 注意:Fetch 的局限性
fetch工具适合抓取单个网页。但如果你需要分析几百份 PDF 格式的上市公司年报,或者网页内容超过了模型的 Token 限制,直接 fetch 会导致报错或遗忘。 解决方案:处理海量、超长文档是 RAG(检索增强生成) 的强项,我们将在后续第六讲中详细拆解如何把"书"切成"片"喂给 AI。
3.5.3 Tool:web_search(网络搜索)
功能:搜索真实的行业新闻、政策动态、市场评价,补充虚构公司所处行业的真实背景
文件路径:src/cufel_deepagent/tools/tools.py
点击展开 web_search 工具配置代码
from langchain.tools import tool

# 使用 @tool 装饰器标记为 Agent 可用的工具
@tool
def web_search(query: str) -> str:
    """搜索网络公开信息

    Args:
        query: 搜索关键词(自然语言描述)

    Returns:
        搜索结果的摘要文本
    """
    # 实际实现会调用搜索 API
    pass
关键说明:
@tool装饰器是 LangChain 的标准用法,自动注册工具- 必须写详细的 docstring,Agent 靠此理解何时调用该工具
- 参数类型注解(
query: str)是必需的,用于生成工具 Schema
3.5.4 SubAgent:writer-agent 和 image-generator-agent
功能:专业化分工,writer-agent 负责撰写文字内容,image-generator-agent 负责生成配图
文件路径:src/cufel_deepagent/subagents/subagents.py
点击展开 SubAgent 配置代码
from cufel_deepagent.subagents.registry import subagent

# 使用 @subagent 装饰器定义子代理
@subagent(
    name="writer-agent",
    description="专业金融文档撰写专家,负责撰写分析报告"
)
def writer_agent():
    """writer-agent 配置"""
    return {
        # SubAgent 的系统提示词
        "system_prompt": "你是一位资深金融分析师,擅长撰写公司研究报告...",
        # 允许调用的工具
        "tools": ["web_search"],
    }

@subagent(
    name="image-generator-agent",
    description="AI 图像生成专家,根据描述生成配图"
)
def image_generator_agent():
    """image-generator-agent 配置"""
    return {
        "system_prompt": "你是一位专业插画师,擅长生成商业配图...",
        "tools": ["generate_image"],
    }
关键说明:
@subagent装饰器是 DeepAgent 框架提供的便捷方式name参数是全局唯一标识,Skill 中通过此名称调用description很重要,帮助主 Agent 决定何时调用该 SubAgent- 每个 SubAgent 有独立上下文,避免复杂任务污染主 Agent 的对话历史
- 需要主 Agent 进行 planning 以免出现异步问题
3.5.5 Skill:industry-research-with-image(行业研究报告)
功能:编排完整工作流程,协调 SubAgent、Tool、MCP 完成"行业研究报告"
文件路径:skills/industry-research-with-image/SKILL.md
点击展开 Skill 文件内容
---
name: industry-research-with-image
description: |
  撰写行业研究报告(含配图)。当用户需要撰写包含图片的行业分析报告时使用。
  会协调 writer-agent 撰写内容,image-generator-agent 生成配图。
---

## 工作流程

当接收到"撰写带图报告"任务时,请按以下步骤执行:

### 首先调用你的 planning\todo 工具进行规划

### 步骤 1:数据收集
1. 根据 analyze-company Skill 指导,调用 `get_company_info`、`get_financial_data` 等工具获取公司数据
2. 使用 web_search Tool 搜索该公司所处行业的最新动态

### 步骤 2:内容撰写
1. 调用 writer-agent SubAgent,传入收集到的所有数据
2. 要求撰写包含以下模块的报告:公司概览、财务分析、行业背景、投资建议
3. 获取 Markdown 格式报告

### 步骤 3:配图生成
1. 分析报告内容,确定需要哪些配图
2. 调用 image-generator-agent SubAgent 生成图片
3. 保存图片到 workspaces/pic/ 目录

### 步骤 4:整合输出
1. 在 Markdown 报告中插入图片引用
2. 保存最终报告到 workspaces/ 目录
3. 返回给用户完整报告路径

## 注意事项

- 公司内部数据为示例格式,行业数据来自公开网络
- AI 生成图片需注明"AI 生成示意图"
关键说明:
- Skill 采用"渐进式披露"设计,框架自动读取 YAML 元数据中的 name 和 description
- 当用户请求匹配 description 描述时,Agent 会加载完整的 SKILL.md 内容
- Skill 不直接执行操作,而是指导 Agent 如何编排工具和 SubAgent
- 这种"指导手册"式的编排,是 DeepAgent 处理复杂任务的核心机制
3.5.6 四大组件协作流程
点击展开:完整流程图(共26行)
用户请求:"撰写带图公司研究报告"
         ↓
    Skill "industry-research-with-image" 被触发
         ↓
    Skill 指导:
    "这是一个带图报告任务,请进行planning撰写todos:
     1. 根据 analyze-company Skill 调用工具获取公司数据
     2. 使用 web_search Tool 搜索行业新闻
     3. 使用 writer-agent 撰写报告内容
     4. 使用 image-generator-agent 生成配图
     5. 整合为最终文档"
         ↓
    SubAgent writer-agent 接收写作任务
         ↓
    writer-agent 可能调用 fetch MCP 获取网页参考资料
         ↓
    writer-agent 返回报告草稿
         ↓
    SubAgent image-generator-agent 接收图像生成任务
         ↓
    image-generator-agent 生成配图保存到 workspace/pic/
         ↓
    配图路径被插入报告
         ↓
    返回带图报告给用户
在这个流程中:Skill 决定做什么、SubAgent 负责专业执行、MCP 提供资料访问、Tool 执行辅助操作。
3.5.7 完整配置地图
本示例涉及的所有配置文件位置汇总:
| 组件类型 | 用途 | 配置文件路径 | 关键配置 |
|---|---|---|---|
| MCP | 获取网页内容 | src/cufel_deepagent/mcp/mcp.py | MCP_SERVERS_CONFIG["fetch"] |
| Tool | 搜索行业新闻 | src/cufel_deepagent/tools/tools.py | @tool def web_search(...) |
| SubAgent | 撰写报告 | src/cufel_deepagent/subagents/subagents.py | @subagent(name="writer-agent") |
| SubAgent | 生成配图 | src/cufel_deepagent/subagents/subagents.py | @subagent(name="image-generator-agent") |
| Skill | 编排工作流程 | skills/industry-research-with-image/SKILL.md | 工作流程 Markdown 文件 |
| Skill | 获取公司数据 | skills/analyze-company/SKILL.md | 虚构公司数据(格式参考) |
配置优先级建议:
-
第一步:配置 Tool(最简单)
- 在
tools/tools.py添加@tool函数 - 适合简单的函数封装
- 在
-
第二步:配置 MCP(连接外部服务)
- 在
mcp/mcp.py添加 MCP 服务器 - 适合使用社区工具(如 fetch、worldbank)
- 在
-
第三步:配置 SubAgent(专业化分工)
- 在
subagents/subagents.py添加@subagent - 适合复杂任务拆分
- 在
-
第四步:编写 Skill(编排工作流程)
- 在
skills/<skill-name>/SKILL.md编写指导手册 - 适合多步骤任务编排
- 在
快速验证清单:
# 测试 MCP 是否连接成功
uv run main.py --run "读取 https://docs.langchain.com/oss/python/langchain/overview 网页内容"

# 测试 Tool 是否可用
uv run main.py --run "搜索新能源汽车行业新闻"

# 测试完整 Skill 流程(请查找合适的 skill)
uv run main.py --run "请查找合适的 skill,撰写一篇关于科技公司的带图研究报告"